Главный принцип хорошего дашборда — он должен отвечать на конкретные вопросы. Работает ли инфраструктура? Есть ли сейчас критические проблемы? Где возникло отклонение? Требуется ли вмешательство администратора?
Не нужно пытаться разместить на одном экране все элементы данных, которые собирает система мониторинга. Гораздо полезнее выбрать ключевые показатели, а подробную диагностику оставить для отдельных дашбордов, графиков и Latest data.
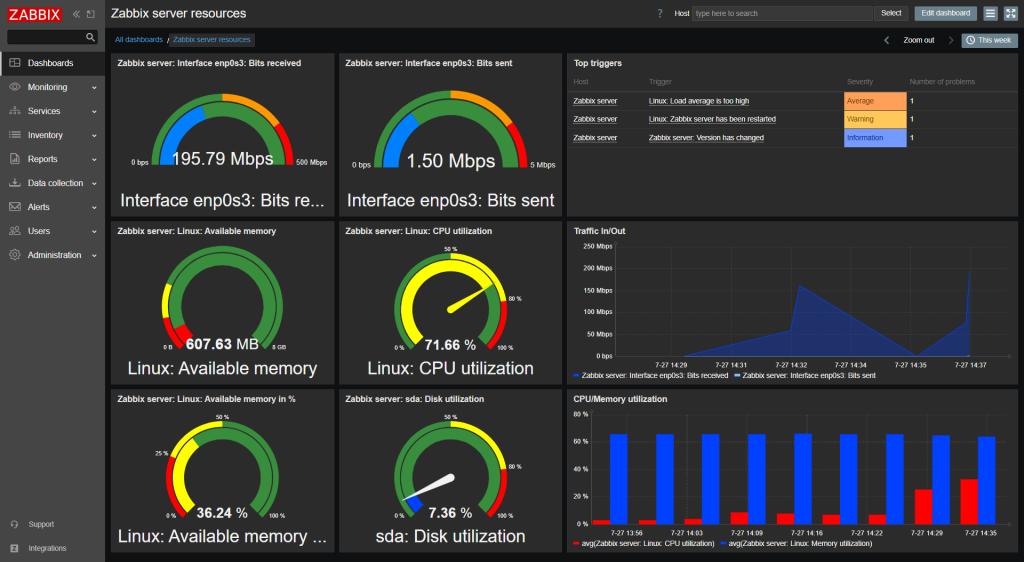
Глобальные метрики
Первый уровень дашборда должен давать общее представление о состоянии инфраструктуры. Здесь не нужны десятки технических показателей — достаточно нескольких метрик, по которым сразу понятно, всё ли работает нормально.
Доступность сервисов и систем
Доступность — один из основных показателей мониторинга. Если критический сервис недоступен, загрузка его процессора или объём свободной памяти уже становятся вторичными.
На верхнем уровне полезно показывать:
- доступность ключевых сервисов;
- количество недоступных узлов;
- состояние бизнес-критичных приложений;
- продолжительность текущих сбоев.
Критические проблемы
Отдельный блок стоит выделить под активные проблемы. При этом лучше не выводить на главный экран сотни событий с низким приоритетом.
Полезнее показать:
- количество критических проблем;
- новые проблемы;
- неподтверждённые события;
- самые продолжительные активные проблемы;
- проблемы по наиболее важным сервисам.
Общее состояние ресурсов
CPU, оперативная память и дисковое пространство тоже полезны, но на глобальном дашборде лучше показывать не каждый сервер отдельно, а именно отклонения.
Например:
- серверы с высокой загрузкой CPU;
- узлы с нехваткой оперативной памяти;
- файловые системы с заканчивающимся свободным местом;
- системы с необычно высокой нагрузкой.
SLA и состояние сервисов
Если в организации используются соглашения об уровне обслуживания, на дашборде можно отображать показатели SLA и состояние соответствующих сервисов.
Это особенно полезно для руководителей и сервисных подразделений: вместо отдельных технических метрик они получают информацию о том, насколько стабильно предоставляется конкретная услуга.
Метрики серверной инфраструктуры
Для системных администраторов нужен более подробный дашборд, позволяющий оценивать состояние серверов и виртуальной инфраструктуры.
CPU и Load
Показывайте текущую загрузку и её динамику. Одного мгновенного значения недостаточно: гораздо полезнее видеть, является ли высокая нагрузка кратковременным пиком или сохраняется продолжительное время.
Оперативная память
Контролируйте использование RAM и связанные показатели. При этом интерпретировать значение нужно с учётом конкретной операционной системы и приложений.
Диски и файловые системы
Для дисков особенно полезны:
- свободное место;
- скорость чтения и записи;
- задержки операций;
- IOPS;
- ошибки накопителей;
- динамика заполнения файловых систем.
Тренд изменения свободного места зачастую полезнее простого значения «сейчас свободно 20%». Если объём уменьшается на несколько процентов каждый день, проблему можно обнаружить задолго до срабатывания критического триггера.
Состояние приложений и служб
Работа операционной системы ещё не означает, что предоставляемый ею сервис исправен.
Поэтому дополнительно стоит контролировать:
- состояние критичных служб и процессов;
- доступность TCP-портов;
- HTTP/HTTPS-проверки;
- время ответа приложений;
- ошибки приложений;
- состояние зависимых компонентов.
Метрики баз данных
Для СУБД набор показателей зависит от используемой системы, но обычно контролируют:
- доступность;
- количество соединений;
- время выполнения запросов;
- блокировки;
- использование памяти;
- размер и рост баз данных;
- репликацию;
- ошибки и состояние журналов.
Лучше создавать отдельный дашборд для базы данных или приложения, чем пытаться разместить все эти показатели на общей панели инфраструктуры.
Сетевые метрики
Для сетевой инфраструктуры важны не только доступность оборудования и загрузка интерфейсов. Хороший сетевой дашборд должен помогать быстро определить, где именно возникла деградация связи.
Загрузка каналов
Отслеживайте входящий и исходящий трафик на критичных интерфейсах. Для магистральных каналов полезно видеть не только текущее значение, но и загрузку за более продолжительный период.
Это помогает выявлять:
- постоянно перегруженные каналы;
- необычные всплески трафика;
- изменения характера нагрузки;
- необходимость расширения пропускной способности.
Задержка и потеря пакетов
Одной доступности по ICMP недостаточно. Узел может отвечать на ping, но качество связи при этом будет неприемлемым.
Поэтому имеет смысл отслеживать:
- latency;
- packet loss;
- нестабильность показателей во времени.
Состояние интерфейсов
Для коммутаторов, маршрутизаторов и другого сетевого оборудования полезно контролировать:
- состояние интерфейсов;
- скорость соединения;
- ошибки передачи;
- discarded packets;
- изменения состояния интерфейса;
- загрузку интерфейса.
Особенно важно отделять действительно значимые интерфейсы от неиспользуемых портов, иначе дашборд быстро заполнится ненужными событиями.
VPN и сетевые сервисы
Если инфраструктура зависит от VPN-туннелей, WAN-каналов или межофисных соединений, их состояние также стоит вынести на отдельную панель.
Например, можно контролировать доступность удалённой стороны, задержку, потерю пакетов, состояние туннеля и объём передаваемого трафика.
Метрики безопасности
Zabbix не является полноценной SIEM-системой или заменой специализированных средств информационной безопасности. Но данные, которые уже собираются системой мониторинга, можно использовать для контроля отдельных событий и состояний, важных с точки зрения безопасности.
Неудачные попытки входа
При наличии соответствующих источников данных можно контролировать резкий рост количества неудачных попыток аутентификации и другие необычные изменения.
Но единичная ошибка входа сама по себе ещё не является атакой — важно учитывать контекст и характер отклонения.
Антивирус и средства защиты
Если необходимые показатели доступны через агента, API, SNMP или другой источник, на дашборд можно вывести:
- состояние антивирусной защиты;
- актуальность баз;
- состояние защитных сервисов;
- результаты отдельных проверок.
Обновления и состояние узлов
Для серверной инфраструктуры полезно контролировать наличие критичных обновлений, состояние служб безопасности и другие технические параметры, которые могут быть получены средствами мониторинга.
Не все метрики должны быть на одном дашборде
Одна из распространённых ошибок — попытка создать единственный «главный» дашборд и разместить на нём вообще всё.
Гораздо удобнее разделить представления по назначению.
Дашборд для руководителя
На нём обычно достаточно:
- доступности ключевых сервисов;
- SLA;
- количества критических инцидентов;
- общего состояния инфраструктуры;
- нескольких действительно важных бизнес-показателей.
Дашборд для дежурного администратора
Здесь важнее:
- активные проблемы;
- недоступные узлы;
- критические триггеры;
- последние события;
- состояние основных сервисов.
Дашборд системного администратора
Можно вывести состояние серверов, CPU, RAM, дисков, виртуализации, служб и систем хранения.
Дашборд сетевого инженера
Основными станут загрузка каналов, packet loss, latency, ошибки интерфейсов, состояние сетевого оборудования и VPN.
Как использовать возможности Zabbix
Одно из преимуществ Zabbix — гибкость при создании дашбордов. Одни и те же данные можно представить по-разному в зависимости от задачи и пользователя.
С помощью дашбордов Zabbix можно:
- контролировать доступность инфраструктуры;
- отслеживать производительность;
- показывать активные проблемы;
- анализировать использование ресурсов;
- наблюдать за изменением показателей во времени;
- строить отдельные панели для разных групп пользователей.
Для визуализации можно использовать различные виджеты, графики, индикаторы, карты и другие элементы интерфейса.
В современных версиях Zabbix отдельные виджеты также могут взаимодействовать между собой. Например, навигационный виджет может определять объект, данные которого отображаются в связанных виджетах. Это позволяет создавать интерактивные панели без необходимости делать отдельный дашборд для каждого сервера или устройства.
Как не перегрузить дашборд Zabbix
При создании дашборда полезно придерживаться нескольких простых правил:
- Показывайте исключения. Не обязательно выводить 100 нормально работающих серверов — важнее сразу увидеть три проблемных.
- Не дублируйте данные. Если одна и та же информация уже представлена удобным виджетом, второй график с тем же показателем обычно не нужен.
- Используйте цвета осмысленно. Если половина экрана красная, цвет перестаёт выполнять функцию предупреждения.
- Разделяйте уровни детализации. Главный экран показывает состояние, специализированные панели помогают искать причину.
- Показывайте тренды там, где они важны. Для дискового пространства или загрузки канала динамика зачастую полезнее одного текущего значения.
- Регулярно пересматривайте дашборд. Если какой-то виджет месяцами не используется при диагностике, возможно, на главном экране он не нужен.
В результате логика мониторинга может выглядеть примерно так:
Общее состояние
      ↓
Проблемный сервис
      ↓
Проблемный узел
      ↓
Конкретная метрика
      ↓
Диагностика причины
Именно такой подход позволяет перейти от общей картины к технической диагностике, не превращая главный дашборд в набор десятков мелких графиков.
Часто задаваемые вопросы
Какие метрики обязательно должны быть на дашборде мониторинга?
Универсального набора нет. Для главного дашборда обычно полезны доступность ключевых сервисов, активные критические проблемы и основные отклонения в состоянии инфраструктуры. Остальные показатели зависят от назначения панели и её пользователей.
Нужно ли выводить CPU и RAM всех серверов на главный экран?
Обычно нет. При большом количестве серверов полезнее показать узлы с аномальной или длительно высокой нагрузкой, а подробные показатели вынести на отдельный дашборд серверной инфраструктуры.
Сколько графиков должно быть на дашборде Zabbix?
Фиксированного количества нет. Добавляйте только те графики и виджеты, которые помогают оценить состояние системы или принять решение. Если элемент не используется при анализе проблем, его стоит убрать с главного экрана.
Нужны ли разные дашборды для администраторов и руководителей?
Да. Руководителю обычно нужны доступность сервисов, SLA и общая картина, тогда как техническому специалисту необходимы активные проблемы, состояние оборудования и более подробные показатели производительности.
Можно ли использовать Zabbix для мониторинга безопасности?
Zabbix может контролировать технические показатели, связанные с безопасностью, если необходимые данные доступны для сбора. Однако он не является полноценной заменой SIEM и специализированным средствам расследования ИБ-инцидентов.
Что важнее на дашборде: текущее значение или график?
Зависит от показателя. Для доступности сервиса часто достаточно текущего состояния, а для загрузки канала, CPU или заполнения диска график помогает понять динамику и отличить кратковременный всплеск от устойчивой проблемы.
Как понять, что дашборд перегружен?
Если администратору требуется долго искать среди графиков действительно проблемный объект или большая часть виджетов не используется при диагностике, дашборд стоит упростить и разделить на несколько специализированных панелей.
Заключение
Дашборд мониторинга — это не просто красивая панель с графиками. Его задача — быстро показать состояние инфраструктуры, привлечь внимание к отклонениям и помочь перейти к поиску причины проблемы.
Поэтому при создании дашборда не стоит стремиться вывести максимум собираемых данных. Начните с доступности ключевых сервисов и активных проблем, затем добавьте показатели серверной и сетевой инфраструктуры, приложений и других компонентов, которые действительно необходимы конкретной группе пользователей.
В Zabbix удобно создавать несколько дашбордов для разных задач: руководитель получает общую картину и SLA, дежурный инженер — активные проблемы, системный администратор — состояние серверов, а сетевой инженер — каналы, интерфейсы и VPN. Такой подход делает мониторинг гораздо полезнее одного перегруженного универсального экрана.
Если вы хотите глубже разобраться в настройке мониторинга на реальных примерах, обратите внимание на курс Zabbix 6. Мониторинг IT инфраструктуры предприятия. В нём последовательно разбираются Zabbix Server, Agent, Proxy, шаблоны, триггеры, уведомления и другие механизмы мониторинга.
Вам понравилась эта статья? Тогда вам, скорее всего, будет интересна другая полезная статья Мониторинг серверов Windows с помощью агента Zabbix.