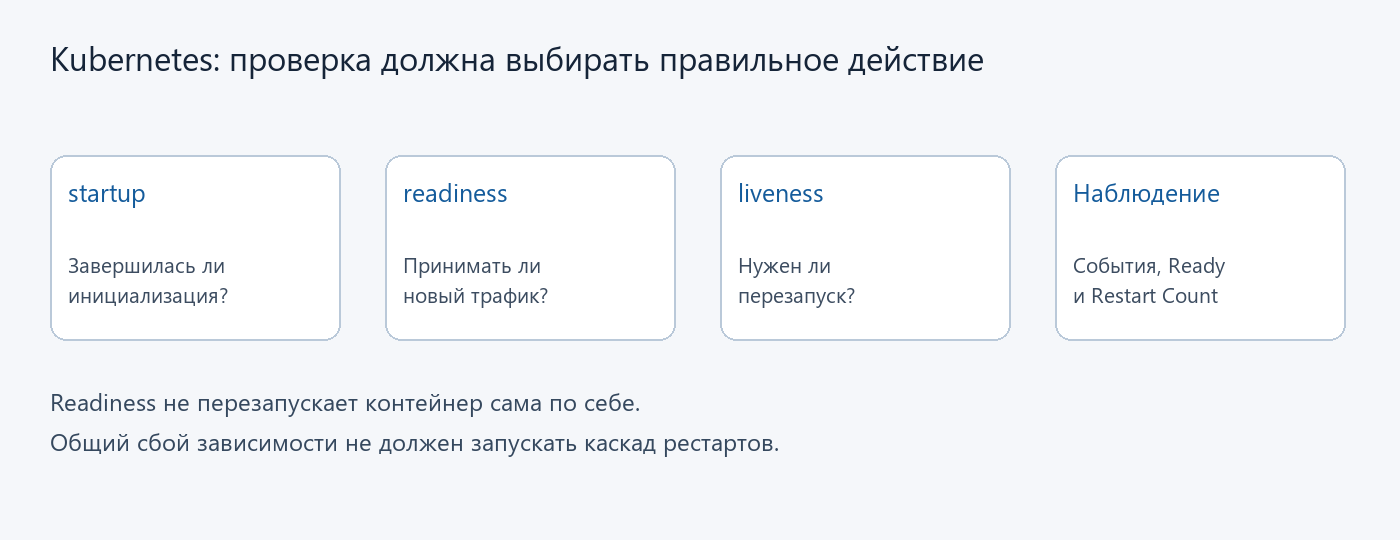
Неудачная проверка здоровья может сама превратить временный сбой в аварию: kubelet перезапускает перегруженные контейнеры, оставшиеся получают ещё больше запросов. Поэтому endpoint и действие проверки выбираются по конкретному отказу, который нужно обнаружить.
Три разных сигнала
| Probe | Вопрос | Последствие неуспеха |
|---|---|---|
| startup | Приложение уже запустилось? | После порога контейнер перезапускается согласно политике |
| readiness | Можно направлять пользовательский трафик? | Контейнер считается неготовым, маршрутизация Service учитывает это |
| liveness | Нужен перезапуск для восстановления? | После порога kubelet перезапускает контейнер |
Неуспех readiness сам по себе не требует уничтожения процесса. Пока startup не успешен, liveness и readiness для этого контейнера не запускаются.
Разделить endpoint приложения
/live должен быть дешёвым сигналом, что процесс способен продолжать работу. /ready отражает готовность обслужить запрос. /startup подтверждает завершение инициализации. Эти URL не создаются Kubernetes автоматически: их реализует приложение.
Временная недоступность общей базы не должна автоматически превращать liveness всех экземпляров в ошибку. Иначе кластер перезапустит исправные процессы, не починив внешнюю зависимость. Для readiness учитывайте, есть ли у приложения допустимый деградированный режим.
Пример фрагмента контейнера
Блок containers размещается в spec.template.spec соответствующего Deployment. Порт и маршруты должны существовать в вашем приложении:
containers:
  - name: app
    image: registry.example.org/team/app:verified-version
    ports:
      - name: http
        containerPort: 8080
    startupProbe:
      httpGet:
        path: /startup
        port: http
      periodSeconds: 5
      timeoutSeconds: 2
      failureThreshold: 60
    readinessProbe:
      httpGet:
        path: /ready
        port: http
      periodSeconds: 5
      timeoutSeconds: 2
      failureThreshold: 3
    livenessProbe:
      httpGet:
        path: /live
        port: http
      periodSeconds: 10
      timeoutSeconds: 2
      failureThreshold: 3
Условное имя образа нужно заменить. Для startup заложено окно порядка 60 × 5 = 300 секунд; реальные тайминги зависят также от длительности проверок и поведения приложения. Это пример расчёта, не универсальные значения для любой нагрузки.
Проверить на пилоте
kubectl -n pilot get pods -w
kubectl -n pilot describe pod <pod-name>
kubectl -n pilot logs <pod-name> -c app --previous
Последняя команда полезна после рестарта, если доступен предыдущий экземпляр. Посмотрите события Unhealthy, Ready и Restart Count. На стенде отдельно проверьте медленный старт, временный отказ зависимости и настоящий зависший процесс.
Не маскировать проблему тайм-аутом
Слишком маленький timeout даёт ложные отказы под нагрузкой. Слишком большой порог откладывает обнаружение зависания. Измеряйте время ответа endpoint и ресурсы контейнера, а не копируйте значения из соседнего проекта.
Перезапуск не исправит утечку памяти в программе или недостаточную мощность всех реплик. Для долгих операций также нужна отдельная стратегия graceful shutdown: liveness не заменяет корректное завершение запросов.
Критерии готовности
- Нормальный медленный старт укладывается в рассчитанное окно.
- Неготовый экземпляр перестаёт получать новый Service-трафик.
- Временный сбой зависимости не вызывает рестарт всей группы.
- Настоящее зависание восстанавливается предусмотренным действием.
- Endpoint не раскрывает конфигурацию или секреты.
Общие определения: Liveness, Readiness, and Startup Probes.
Источник материала: Kubernetes probes: чем отличаются startup, readiness и liveness (англоязычный материал разработчиков). Русскоязычная инструкция подготовлена самостоятельно; технические сведения проверены 11 октября 2026 года.